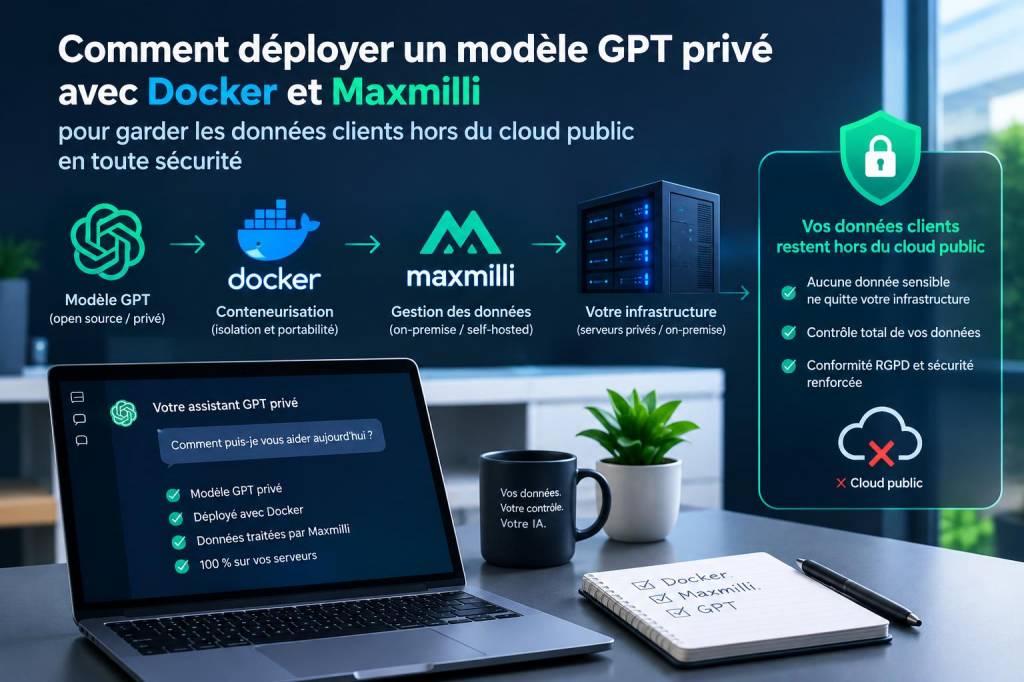
Déployer un modèle GPT en privé, hors des clouds publics, c’est devenu pour moi une nécessité quand je travaille avec des clients manipulant des données sensibles. Je veux garder le contrôle total sur les données, assurer la traçabilité et réduire les risques de fuite. Ici je vous explique comment je procède avec Docker et maxmilli (outil de gestion/serving local de modèles), en couvrant l’installation, la sécurité réseau, la gestion des modèles et quelques bonnes pratiques opérationnelles.
Pourquoi opter pour un déploiement privé
J’ai souvent vu des équipes commencer par des APIs publiques (OpenAI, Anthropic, etc.) et basculer ensuite vers du privé pour trois raisons principales :
Confidentialité : garder les prompts et les retours en interne.Contrôle des coûts et latence : éviter les dépendances et les coûts variables des APIs.Conformité : respecter des contraintes réglementaires (RGPD, exigences sectorielles).Déployer localement ne veut pas dire « bricoler » : avec Docker et des outils comme maxmilli, on obtient une solution reproductible, scalable et relativement simple à maintenir.
Architecture cible
Voici l’architecture que j’utilise typiquement :
Un container Docker qui sert le modèle via maxmilli (API REST/gRPC).Un reverse proxy (nginx ou Caddy) pour TLS, authentification et routage.Une base d’indexation locale pour les embeddings (Chroma, Milvus, Weaviate selon besoin).Un stockage chiffré pour les données persistantes (volumes Docker chiffrés ou disque LUKS).Optionnel : GPU via NVIDIA Container Toolkit pour accélérer l’inférence.Prérequis
Avant de commencer, assurez-vous d’avoir :
Une machine (on-prem ou VM privée) avec Linux.Docker et docker-compose installés.Si GPU : pilotes NVIDIA + nvidia-docker2 / NVIDIA Container Toolkit.Le binaire ou l’image Docker de maxmilli (remplacez par l’URL de l’image si vous l’hébergez en interne).Un modèle compatible (LLM) téléchargé et stocké localement ou accessible via dépôt privé.Exemple minimal de docker-compose
Voici un fichier docker-compose.yaml que j’utilise comme point de départ. Adaptez les chemins et les variables.
version: '3.8'
services:
maxmilli:
image: registry.internal/maxmilli:latest
restart: unless-stopped
volumes:
- ./models:/models:ro
- ./data:/data
environment:
- MODEL_PATH=/models/my-gpt
- MAXMILLI_API_KEY_FILE=/run/secrets/maxmilli_api_key
secrets:
- maxmilli_api_key
reverseproxy:
image: caddy:latest
ports:
- '443:443'
volumes:
- ./Caddyfile:/etc/caddy/Caddyfile
- caddy_data:/data
secrets:
maxmilli_api_key:
file: ./secrets/maxmilli_api_key
volumes:
caddy_data:
Je place toujours la clé d’API (ou le token d’accès) dans Docker secrets plutôt que dans des variables d’environnement pour limiter les fuites.
Configurer maxmilli pour inference locale
La configuration de maxmilli dépendra du format du modèle (GGML, PyTorch, etc.). En général, je :
place le modèle dans le volume /modelsfournis un fichier de config qui indique le backend (CPU/GPU), le tokenizer et les paramètres d’optimisation (quantization, beam size, etc.)Exemple simplifié de configuration (format JSON) :
{
"model_path": "/models/my-gpt",
"backend": "cuda",
"max_tokens": 512,
"quantization": "int8"
}
Sécuriser l’accès
La sécurité est la pièce maîtresse. Voici les mesures que j’applique systématiquement :
TLS obligatoire : utiliser un reverse proxy (Caddy, nginx) pour terminer TLS. Si le serveur n’a pas d’accès public, j’utilise des certificats internes signés par mon PKI.Authentification : API keys, mTLS ou OAuth2. Pour un usage interne j’opte souvent pour mTLS + tokens court-vie.Réseau : limiter l’accès au port d’API via firewall (iptables, ufw) ou VPC privée.Chiffrement des volumes : pour les données sensibles je chiffrerai les disques avec LUKS ou utiliserai un provisioner de volumes chiffrés.Audit et logging : logger les requêtes (headers épurés), surveiller les modèles d’usage pour détecter des fuites ou une exfiltration.Gestion des données clients et embeddings
Quand j’intègre des données clients (documents, emails, tickets) pour faire du RAG (retrieval-augmented generation), je procède ainsi :
Prétraitement local : nettoyer et anonymiser ce qui peut l’être.Génération d’embeddings en local : j’utilise un endpoint interne de maxmilli ou un modèle d’embeddings local pour ne jamais envoyer les données au cloud.Stockage dans une vector DB locale : Chroma, Milvus ou Weaviate peuvent être déployés en Docker. Je les configure pour qu’ils ne soient accessibles que depuis le réseau interne.Mécanismes de purge : définir une politique de rétention et de suppression des données clients sur demande.Performance et scalabilité
Quelques conseils que j’applique pour maintenir de bonnes performances :
Utiliser des modèles quantifiés (int8, int4) si la qualité suffit pour le cas d’usage.Activer le batching et le caching des réponses pour des requêtes similaires.Sur des systèmes GPU, monitorer l’utilisation mémoire et lancer plusieurs replicas si nécessaire derrière un load balancer.Si le modèle est trop lourd pour une seule machine, envisager un split inference (encoder local, decoder sur un noeud différent) ou un modèle retravaillé pour on-device.Processus de mise à jour et gouvernance
Garder le contrôle implique aussi une gouvernance rigoureuse :
Versionner les modèles et garder un registre (image + hash) afin de pouvoir revenir en arrière.Tests de non-régression pour vérifier que les mises à jour n’introduisent pas de comportements indésirables.Processus d’accès : qui peut charger un nouveau modèle, qui peut exporter des logs — tout doit être tracé.Exemples d’erreurs courantes et comment les éviter
En pratique, j’ai rencontré plusieurs pièges qui reviennent souvent :
Exposer l’API sans auth : double vérification des règles du reverse proxy et des security groups.Stocker les clés dans les images Docker : utiliser les secrets et vaults (HashiCorp Vault, AWS Secrets Manager si vous avez un composant cloud de confiance).Sous-estimer l’usage mémoire : tester avec des données représentatives et prévoir des mécanismes d’OOM graceful.Si vous voulez, je peux vous fournir un template complet docker-compose adapté à votre modèle (CPU ou GPU) ainsi qu’un Caddyfile pour l’authentification mTLS. Indiquez-moi votre contexte (taille du modèle, GPU dispo, contraintes réseau) et je vous prépare ça sur-mesure.